honkoma Journal / AI活用
AIサイバー攻撃に「うちのAIは断る」は通用しない?|情シス向け
AIサイバー攻撃は、無検閲(Uncensored/Abliterated)AIを前提に考える時代です。ローカルLLMを社内の隔離環境で動かし、データを外に出さずに社内の権限と情報の扱いを確かめる考え方と、その一例としてのペネトレーションテストを、人材・個人情報を扱う会社向けに解説します。
普段から画像モデルやLLMの開発を行っている、株式会社honkomaの林拓海です。この記事では、LLMの基礎的な解説(大規模言語モデルがどう作られているかなど)は省きます。それよりも、いま何が起きていて、会社として何を守るべきかをお話しします。
この数日、タイムズカーで約660万件の個人情報が漏えいし、「銀のさら」などでも最大約650万件が漏えいした可能性があると報じられました。「うちのAIは危険な依頼を断るから大丈夫」と思っている経営者や情報システム担当の方にこそ、読んでほしい記事です。専門用語は、出てくるたびに平易に説明します。
先に結論を書きます。攻撃者は、おそらくすでに無検閲のAIを使っています。「これから使われるかもしれない」という未来の予想ではなく、すでに手元で動かしている前提で、会社の守りを考えておく必要があります。
必要なのは、攻撃者より先に、LLMを使って社内の権限・情報・AIの使い方を確かめることです。社内の隔離された環境でAIを動かし、データを外に出さずに、権限や情報の扱いに穴がないかを確かめます。外部のクラウドサービスに社内の機密や個人情報を送るのではなく、手元で安全に検証を進めるアプローチです。
自社のAIが危険な依頼を断っても、それでわかるのは、自社で使っているAIが依頼を断ったことまでです。相手が別のAIを使っても、自社のシステムは守れるのか。そこを確かめておく必要があります。
こんな人におすすめ
- AIサイバー攻撃への備えを考えている経営者・情報システム担当者
- 人材・個人情報を大量に扱う会社(人材会社、EC、医療など)
- 社内データを外に出さず、生成AIセキュリティを監査したい方
- ローカルLLMやペネトレーションテストの活用を検討している方
「無検閲AI」とは何か
Uncensored と Abliterated、2つの呼び方
ふつうのAIには、「危険な依頼は断る」という安全のための働きが組み込まれています。悪用につながるような質問を受けると、AI自身が「その質問には答えられません」とブレーキをかける仕組みです。無検閲(Uncensored)モデルは、この断る働きが弱い、あるいは完全に取り除かれたモデルのことです。
Abliterated(アブリテレーテッド)は、無検閲モデルの作り方のひとつから付いた呼び名です。もとのモデルから「断る働き」の部分だけを取り除いたもの、と理解してください。作り方そのものは、悪用を避けるためにもこの記事では書きません。
こうしたモデルは、すでに存在しています。だから私は、「攻撃者はすでに使っている」と考えています。
本質は「何でもやる」ではなく「確かめるところまでやる」
無検閲モデルの怖さは「何でもやる」ことだと思われがちです。映画に出てくるような凶悪なプログラムを一瞬で作るとか、そうした派手な話を想像するかもしれません。ですが、私が現場で注目しているのは別の点です。見つけた穴に実際に入り込み、何が起きるかを確かめるところまで進められる、という点です。
たとえば、監査で「この権限設定には問題がありそう」「この入力処理には穴があるかもしれない」と指摘されたとします。ただ、それだけでは本当に見えてはいけない情報を見られる穴なのか、想定した範囲を超えて操作できるのか、机上の指摘を読むだけでは実際の影響の大きさまではわかりません。
ClaudeやOpenAIのモデルのような企業向けのAIは、設定の確認やコードの分析など、ある程度の監査はしてくれます。でも、「じゃあ実際にそこから侵入できるか試してみて」と頼むと、安全基準に引っかかって断ります。防御のための正当なテストであっても、危険な操作と判定されて止まってしまうわけです。一方で、攻撃者が使う無検閲モデルは、そこで止まりません。
だからhonkomaでは、指摘を集めて終わらせず、必要な箇所は書面で合意した範囲で、実際に確かめます。本当に自社の防壁を突破されてしまうのか、確かめなければ、実効性のある守り方は見えてこないからです。
個人情報の漏えいを、自社の問題として考える
冒頭で触れた2件の報道を、もう少し詳しく見ます。
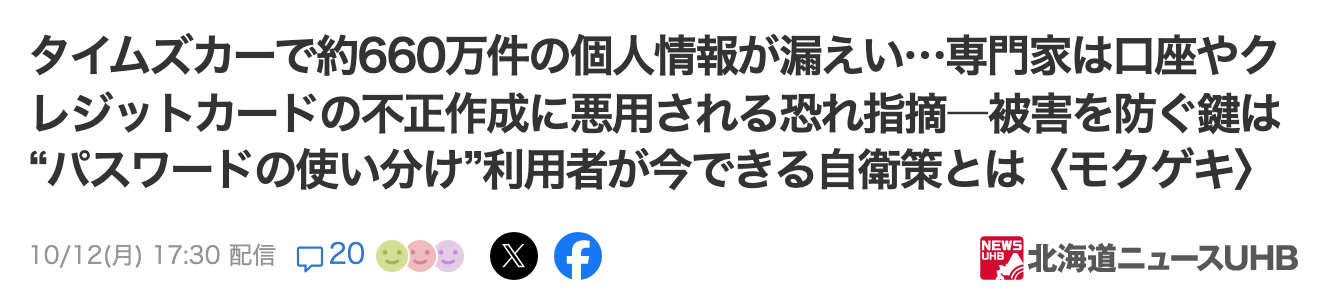
2026年10月12日、カーシェア大手のタイムズカーで約660万件の個人情報が漏えいしたと報じられました。一部には運転免許証の画像も含まれ、専門家は口座やクレジットカードの不正作成に悪用される恐れを指摘しています。同じ記事で専門家は、流出が相次ぐ背景を「生成AIの普及により、人間と違って24時間、多くの企業に自動的に攻撃できるようになった」と分析しています。人間が手作業で侵入を試みる時代から、AIが休まず穴を探し続ける時代に移っているということです。
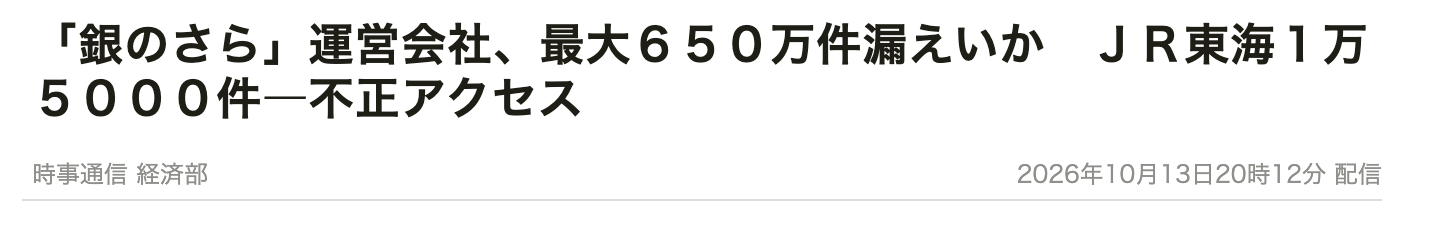
翌13日には、宅配すし「銀のさら」などを展開する会社で、「銀のさら」「すし上等」「釜寅」の公式サイトとアプリの登録者情報が、最大約650万件漏えいした可能性があると報じられました。私たちの日々の暮らしに密着した身近なサービスでも、これだけの規模のインシデントが起きています。
これらの漏えいの原因が無検閲AIだ、という話ではありません。ただ、相手が危険な依頼を断らないAIを使えるなら、こちらのAIが断ることを防御の前提には置けません。攻撃側の手元には、すでにブレーキのない道具があると考えたほうが自然です。
特に人材会社、EC、医療など、個人情報を大量に扱う企業では、誰がどの情報を見られるか、どこまで操作できるかを確認しておく必要があります。履歴書や顧客リスト、診療データは、一度漏れたら取り返しがつきません。社内でAIを使わないと決めても、攻撃者が使うAIは選べません。自社がAIを活用しているかどうかに関係なく、守りの見直しが迫られています。
攻撃側の仕組み:指揮役が無検閲なら、ほかは普通のAIでいい
オーケストレーションとサブエージェント
最近のAIは、1つで全部をこなすのではなく、複数のAIで仕事を分担します。全体の指揮をとるAIが仕事を割り振り、結果をまとめる。この仕組みをオーケストレーションと呼びます。
指揮役の下で、割り振られた作業をこなすAIをサブエージェントと呼びます。会社でいえば、指揮役が現場監督、サブエージェントが作業員です。監督が「この部分のログを調べて」「この通信を整理して」とタスクを切り分け、現場の作業員が手を動かして報告を戻すイメージです。
無検閲なのは、指揮役1つで足りる
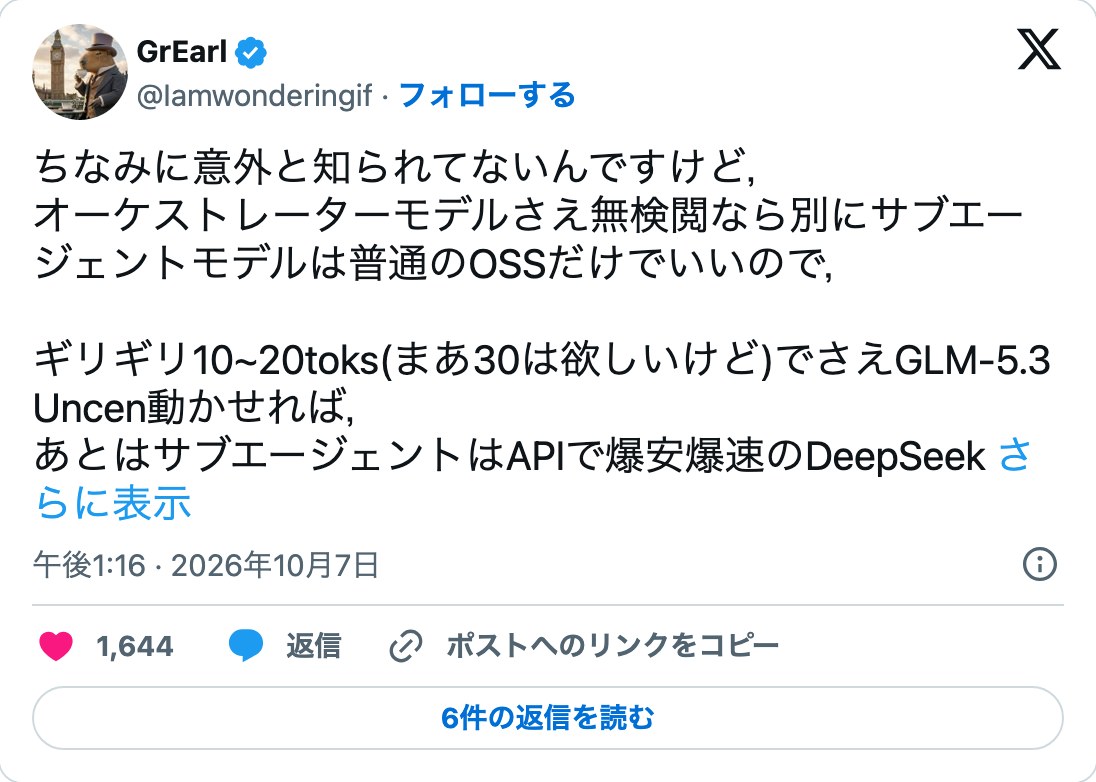
Xユーザーの @Iamwonderingif さんは、指揮役のモデルさえ無検閲なら、サブエージェントは普通の公開モデルでよく、しかも安くて速いもので足りる、と指摘しています。
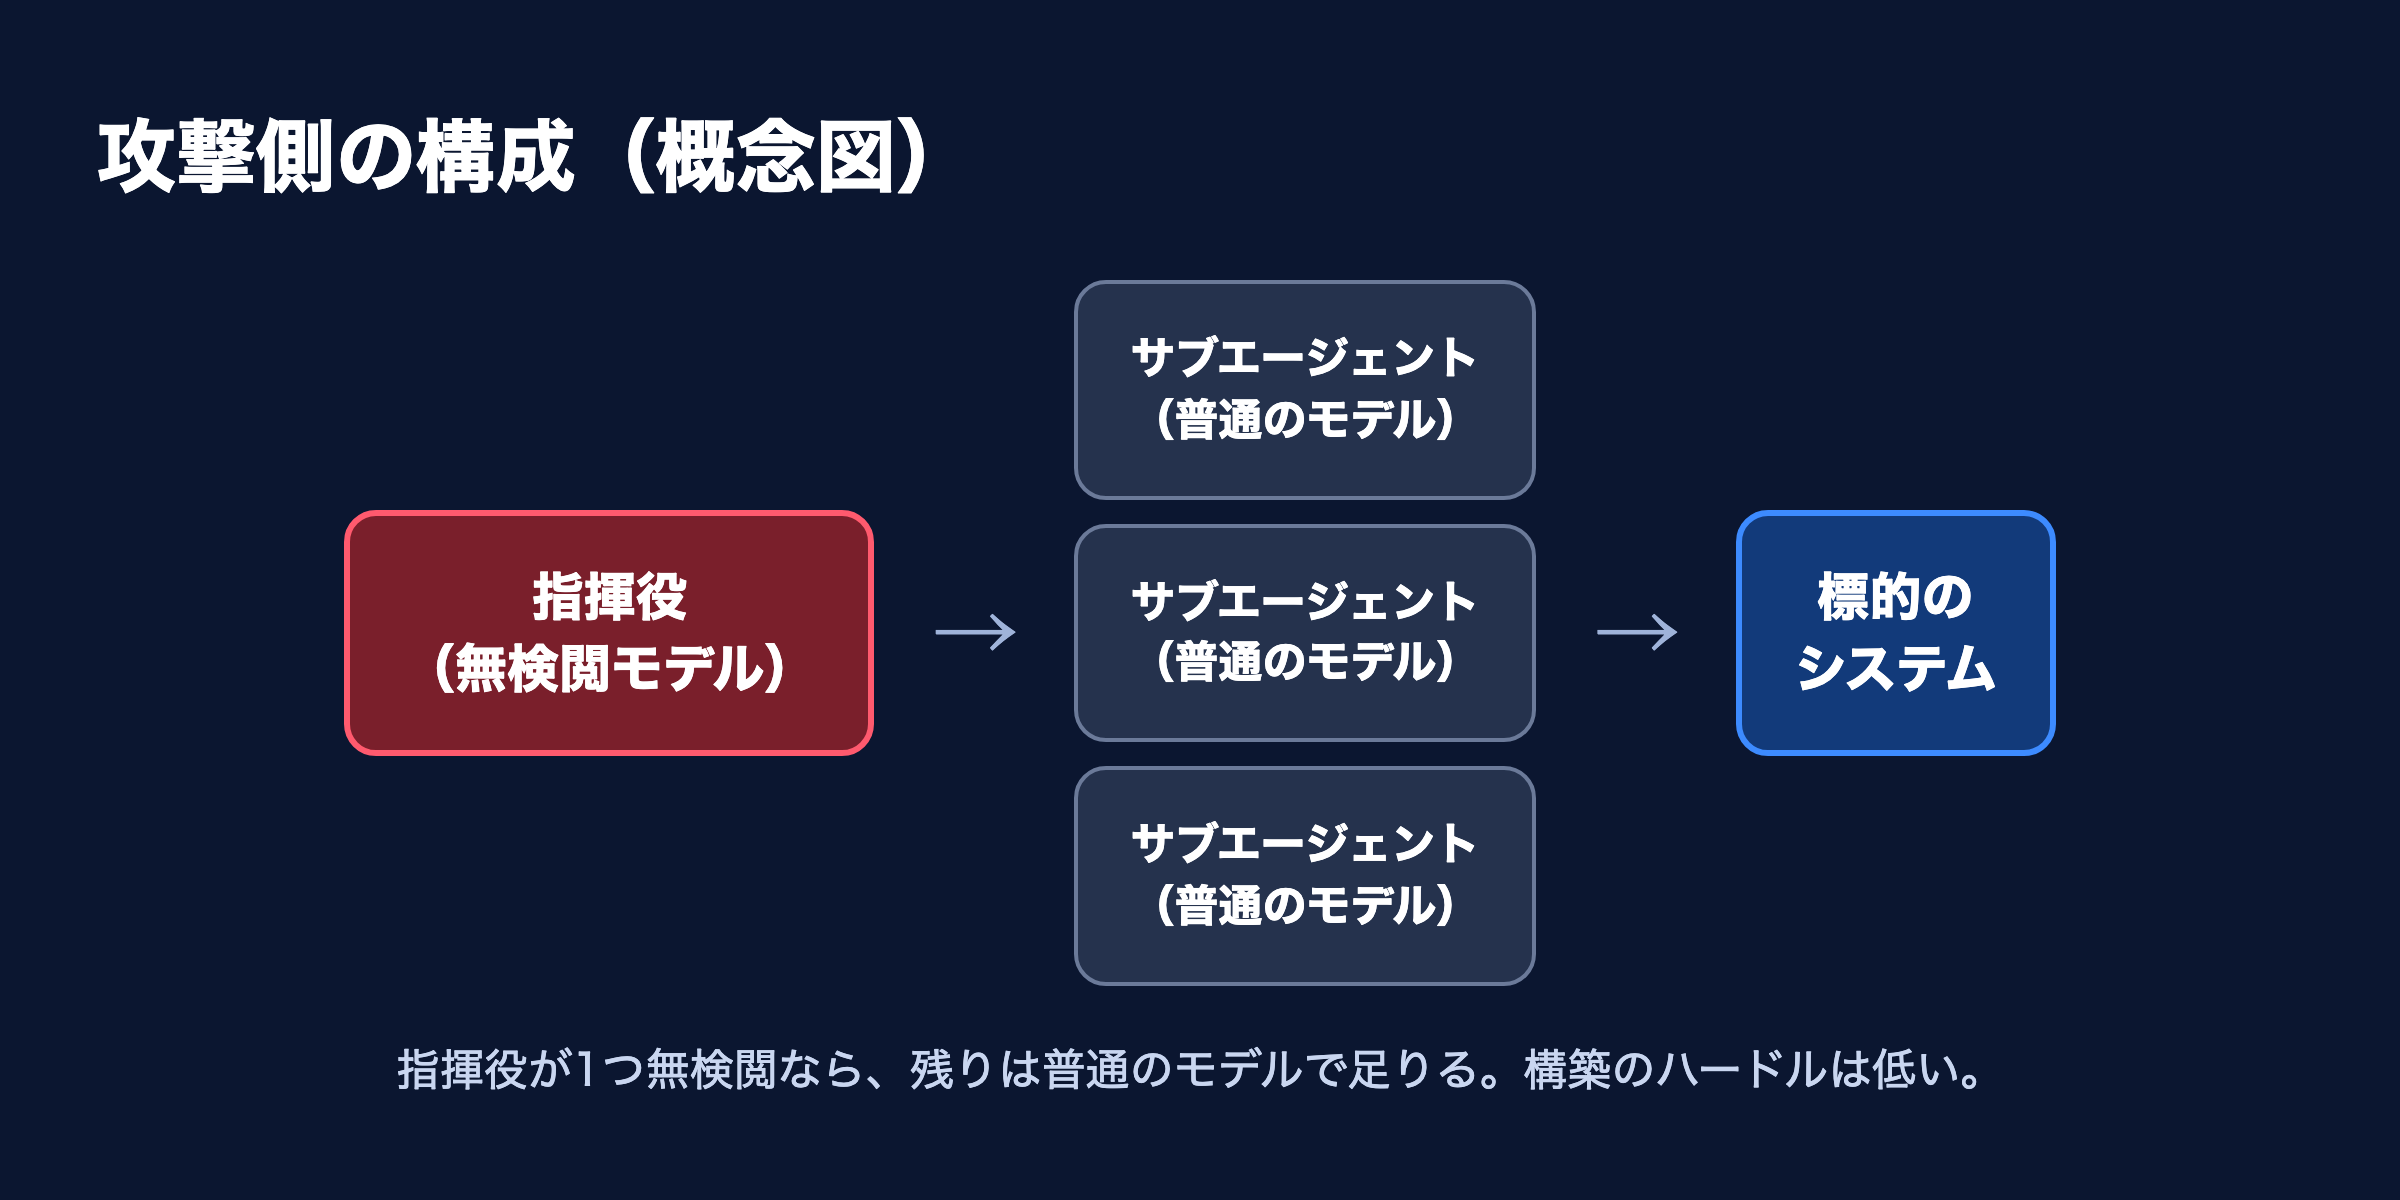
図のとおり、無検閲なのは上に立つ指揮役だけです。実際に手を動かすサブエージェントは、どこにでもある普通のAIで構いません。
すべてを特別なモデルにする必要がないので、攻撃側は環境を組み立てやすくなります。高価な設備がなくても組めてしまう。ここが怖いところです。
攻撃側は、安く、休まず、穴を探し続けられます。だから守る側も、攻撃者に見つけられる前に、自社の権限や情報の扱いに穴がないかを確かめておく必要があります。
対策:ローカルLLMで、社内の権限と情報の扱いを確かめる
ローカルLLMとは
ローカルLLMは、自分たちが管理するサーバーやパソコンの中で動かす言語モデルです。インターネット越しに外部のサービスへ質問を送るのではなく、手元で動かします。社外のクラウドにデータを送らずに済みます。
何を監査するのか
監査では、設定やコードだけでなく、業務で使う権限、AIが読める情報、外部へ渡るデータまで見ます。単に設定ファイルの記述ミスを探すだけでは、実際の業務リスクを防ぎきれないからです。
AIを業務に使っている場合は、AI同士の連携も確かめます。AI同士で仕事を分けたときに、ある担当には見せないはずの情報が、別の担当を通じて渡っていないか。AIが出した結果を、誰の権限で実行するのか。人が承認する箇所は決まっているか。こうした点を、ひとつずつ確かめます。特にAIが自律的にツールを呼び出すような仕組みでは、権限の分離が甘いと思わぬ事故につながります。
AIを使っても、AI任せで全部確認したことにはできません。AIに指示を投げて「問題ありませんでした」と言われたとしても、どこを見てどこを見ていないのかが分からなければ意味がないからです。だからこそ、対象を一覧にして、確認できた箇所と、確認していない箇所を分けて報告します。見つかった問題は、影響を整理し、直す順番をお客様と一緒に決めます。
プロンプトインジェクションとは
プロンプトインジェクションは、AIが読む情報の中に紛れ込んだ指示で、AIの動作が変わってしまう問題です。AIは人間と違い、「読むための文章」と「従うべき指示」の区別が苦手だからです。たとえば、要約を頼んだ文書の中に別の指示が紛れていて、AIがそちらに従ってしまう、といったことです。生成AIセキュリティでは、まず確認したい問題のひとつです。
入力された情報をどこまで信用し、何を実行してよいか。この線引きは、業務の担当者と一緒に整理します。システム側で入力を無害化する工夫も必要ですし、AIに与える権限を最小限に絞り込む設計も欠かせません。
ペネトレーションテストとは
ペネトレーションテスト(侵入テスト)は、許可を得たうえで、システムに実際に入り込めるか、入れた場合にどこまで影響が及ぶかを確かめるテストです。依頼した会社の許可を得て、対象と範囲を決めて行います。第三者が無断で行えばサイバー攻撃ですが、事前に合意したルールの中で弱点を見つけるために行うテストです。
これは、監査で見つかった穴を実地で確認する方法の一例です。すべての確認を侵入テストで済ませる必要はありません。設定や権限の見直しで判断できるものもあれば、実際に確かめる必要があるものもあります。会社ごとの環境やリスクの大きさに合わせて、現実的な手法を選びます。
データを外に出さず、社内の隔離環境で完結させる
監査のために個人情報を外へ持ち出す形では、相談しづらい会社もあると思います。自社の重要データを外部に預けること自体がリスクになってしまっては、本末転倒だからです。だからhonkomaでは、監査を手伝うAIに、お客様社内の隔離環境に置いたローカルLLMを使います。隔離環境とは、外のネットワークから切り離した、閉じた場所のことです。
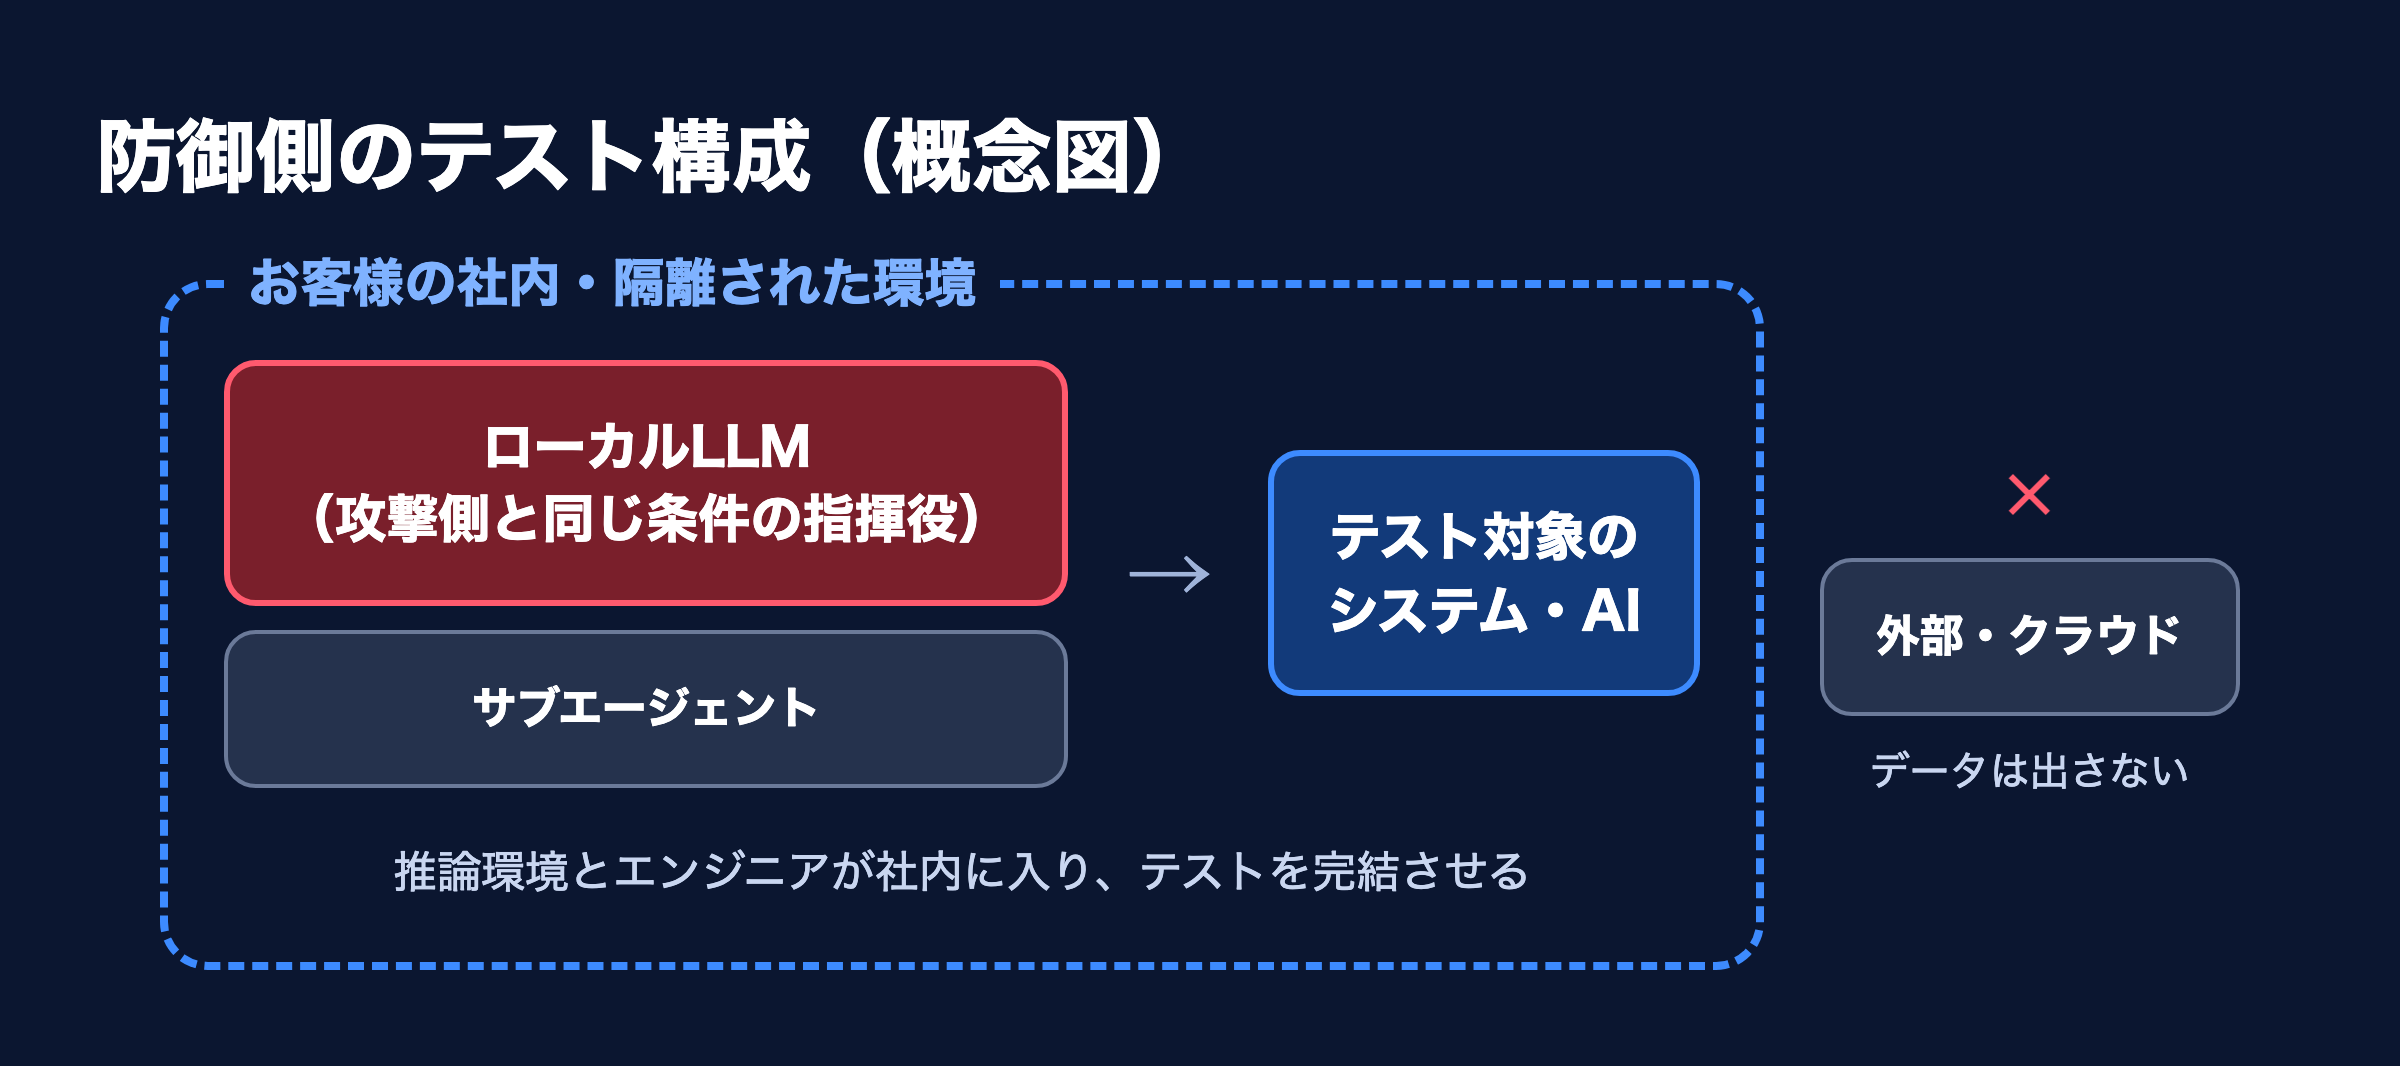
図のように、ローカルLLM、作業を分担するAI、テスト対象を社内の隔離環境に置きます。無検閲の指揮役を使う場合も、この中で扱います。閉じた環境だからこそ、踏み込んだ検証ができます。
モデルが社内で動くだけでは足りません。監査中に扱うデータも、結果や記録も、外部のAIサービスには渡しません。外部のAIへ処理を渡す構成は、この監査環境には持ち込みません。
そのうえで、触れてよい対象と権限を、着手前に書面で決めます。報告では、確認できた範囲と確認していない範囲を分けて書きます。修正が済んだら、同じ方法で直っているかをもう一度確かめます。監査で分かった結果は、社名を伏せても公開・事例化しません。指摘して終わりにせず、直ったところまで確かめる。それが、私の考える社内監査です。
データを社外に出さずに、自社の権限と情報の扱いを確かめたい。脆弱性診断・セキュリティ対策について、そんな対象や課題をフォームからご相談いただけます。ご相談はこちら
まとめ
- 攻撃者は、おそらくすでに無検閲AIを使っている。自社のAIが断ることを、防御の前提にはできない。
- 無検閲モデルの本質は、穴が本当に穴かを確かめるところまでやれること。企業向けAIは、そこを断る。
- 守る側は、ローカルLLMを社内の隔離環境に置き、権限・情報・AIの使い方を確かめる。ペネトレーションテストはその一例。
- 監査で扱うデータや記録は、外部のAIサービスに渡さない。人材・個人情報を大量に扱う会社ほど、早めに確認しておく必要がある。
👉 脆弱性診断・ペンテストを相談する
脆弱性診断・セキュリティ対策について、対象や課題をフォームからご相談いただけます。
ご相談はこちらまずはご相談ください。ご相談で費用をいただくことはありませんので、ぜひ一度お話を聞かせてください。どんな対策ができるか、コスト感の確認、相見積もりの検討だけでもOKです。